{
"cells": [
{
"cell_type": "markdown",
"id": "9b2b0fdb",
"metadata": {},
"source": [
"# 预训练语言模型微调与部署\n",
"\n",
"> 导读: 该部分介绍预训练模型微调\n",
"想提升预训练模型在指定任务上的性能?让我们选择合适的预训练模型,在特定任务上进行微调,并将微调后的模型部署成方便使用的Demo!\n",
"## 本教程目标:\n",
"1. 熟悉使用Transformers工具包\n",
"2. 掌握预训练模型的微调、推理(解耦可定制版本 & 默认集成版本)\n",
"3. 掌握利用Gradio Spaces进行Demo部署\n",
"4. 了解不同类型的预训练模型的选型和应用场景"
]
},
{
"cell_type": "markdown",
"id": "24537205",
"metadata": {},
"source": [
"## 本教程内容:"
]
},
{
"cell_type": "markdown",
"id": "880a3bc7",
"metadata": {},
"source": [
"### 1. 工作准备:\n",
"#### 1.1 了解工具包:Transformers\n",
"https://github.com/huggingface/transformers\n",
"\n",
"> 🤗 Transformers 提供了可以轻松地下载并且训练先进的预训练模型的 API 和工具。使用预训练模型可以减少计算消耗和碳排放,并且节省从头训练所需要的时间和资源。这些模型支持不同模态中的常见任务,比如:\n",
"📝 自然语言处理:文本分类、命名实体识别、问答、语言建模、摘要、翻译、多项选择和文本生成。\n",
"🖼️ 机器视觉:图像分类、目标检测和语义分割。\n",
"🗣️ 音频:自动语音识别和音频分类。\n",
"🐙 多模态:表格问答、光学字符识别、从扫描文档提取信息、视频分类和视觉问答。\n",
"\n",
"详细中文文档:https://huggingface.co/docs/transformers/main/zh/index\n",
"\n",
"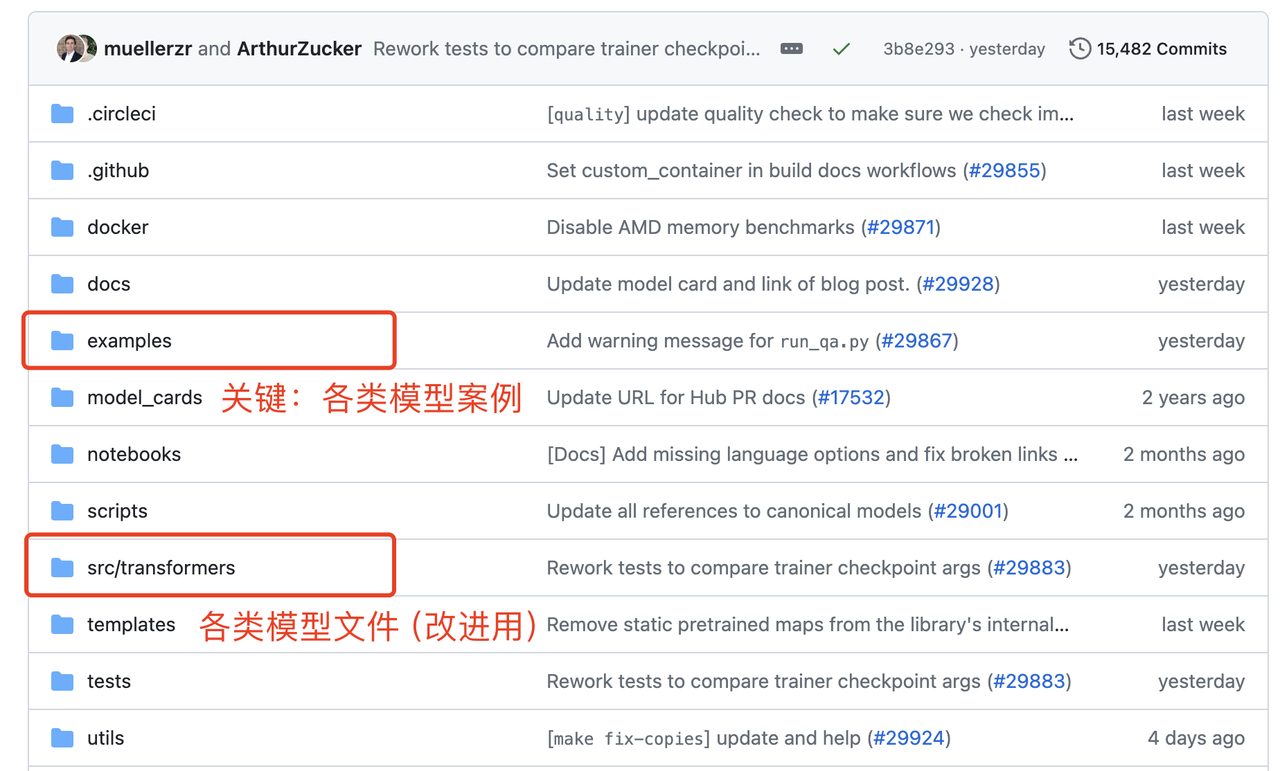\n",
"\n",
"#### 1.2 安装环境:以文本分类(e.g., 虚假新闻检测)为例\n",
"1. 我们进入到文本分类的案例库,参考readme了解关键参数,下载requirements.txt和run_classification.py\n",
"\n",
"https://github.com/huggingface/transformers/tree/main/examples/pytorch/text-classification\n",
"\n",
"2. 安装环境:\n",
"- 1. 通过conda创建新的环境:conda create -n llm python=3.9\n",
"- 2. 进入虚拟环境:conda activate llm\n",
"- 3. pip install transformers\n",
"- 4. 删除requirements.txt中自动安装的torch,pip install -r requirements.txt\n",
"\n",
"> 若下载速度慢,可使用国内源:pip [Packages] -i https://pypi.tuna.tsinghua.edu.cn/simple\n",
"\n",
"> 若使用国内源安装pytorch,将自动选择pytorch的cpu版本,无法运行gpu,因此——\n",
"\n",
"- 5. conda install pytorch\n",
"\n",
"> 若下载速度慢,可按照该博客配置conda镜像:https://blog.csdn.net/weixin_42797483/article/details/132048218\n",
"\n",
"3. 准备数据:我们以Kaggle上的虚假推文数据集为例:https://www.kaggle.com/c/nlp-getting-started/data\n",
"\n",
"#### 1.3 处理好的工程包(演示代码和数据)\n",
"(1)解耦可定制版本(关键模块解耦,方便理解,可自定义数据加载、模型结构、评价指标等)\n",
"\n",
"[TextClassificationCustom下载链接](https://drive.google.com/file/d/12cVWpYbhKVLTqOEKbeyj_4WcFzLd_KJX/view?usp=drive_link)\n",
"\n",
"(2)默认集成版本(代码较\n",
"为丰富、复杂,一般直接超参数调用,略有开发门槛)\n",
"\n",
"[TextClassification下载链接](https://drive.google.com/file/d/10jnqREVDddmOUH4sbHvl-LiPn6uxj57B/view?usp=drive_link)\n",
"\n"
]
},
{
"cell_type": "markdown",
"id": "9fa6849f",
"metadata": {},
"source": [
"### 2. 基于解耦版本进行定制开发(最小可行性产品MVP)\n",
"共三个主要文件:main.py主程序,utils_data.py数据加载和处理文件,modeling_bert.py模型结构文件\n",
"\n",
"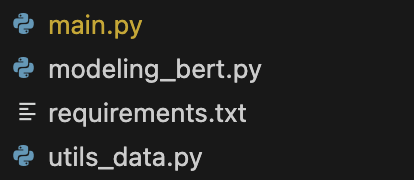\n",
"\n",
"#### 2.1 理解关键模块\n",
"1. 加载和处理数据(utils_data.py)\n",
"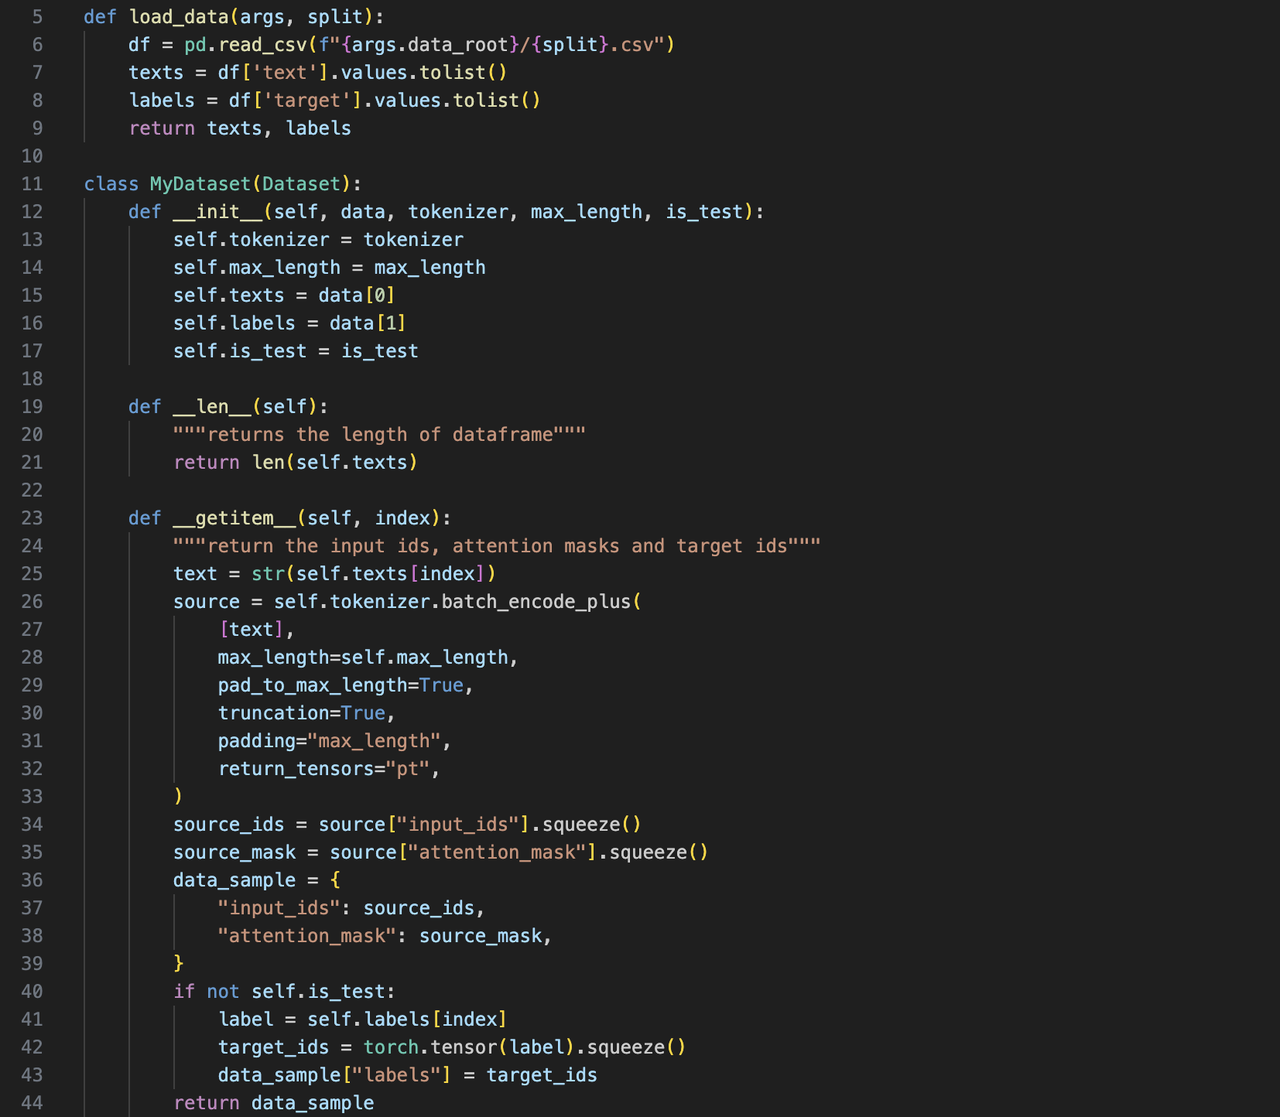\n",
"\n",
"2. 加载模型(modeling_bert.py)\n",
"\n",
"\n",
"\n",
"\n",
"\n",
"\n",
"3. 训练/验证/预测(main.py)\n",
"\n",
"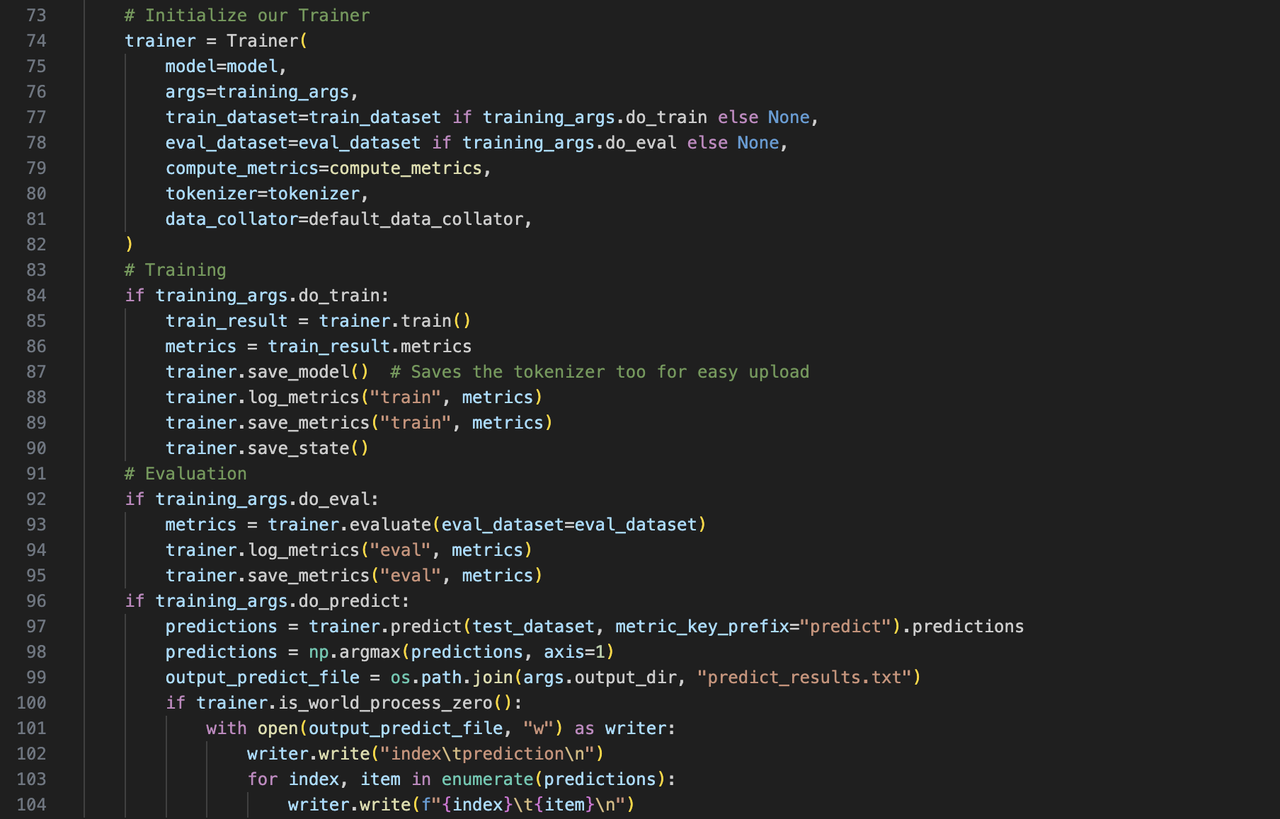\n",
"\n",
"#### 2.2 运行训练/验证/预测一条龙\n",
"```shell\n",
"python main.py\n",
"```\n"
]
},
{
"cell_type": "markdown",
"id": "1c833af8",
"metadata": {},
"source": [
"### 3. 基于集成版本进行微调(Optional,基于run_classification.py)\n",
"\n",
"#### 3.1 理解关键模块:\n",
"1. 加载数据(csv或json格式)\n",
"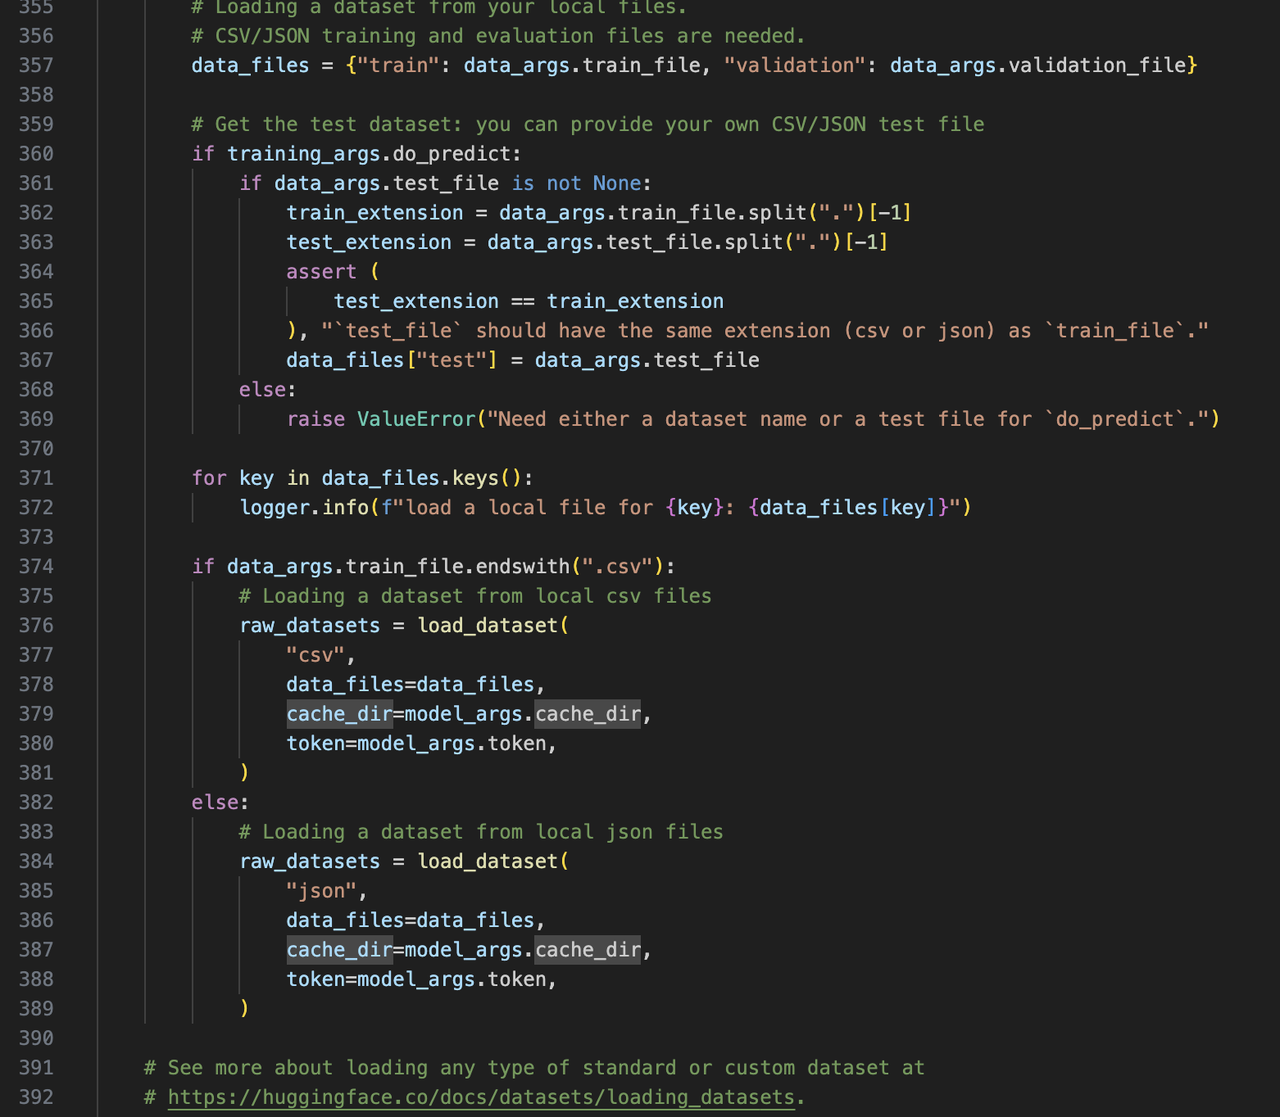\n",
"\n",
"2. 处理数据\n",
"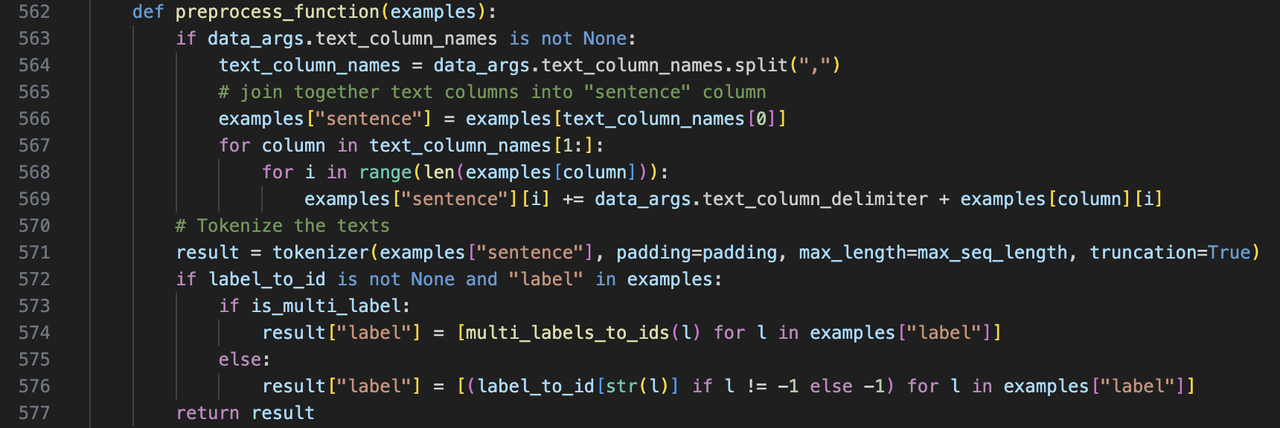\n",
"\n",
"3. 加载模型\n",
"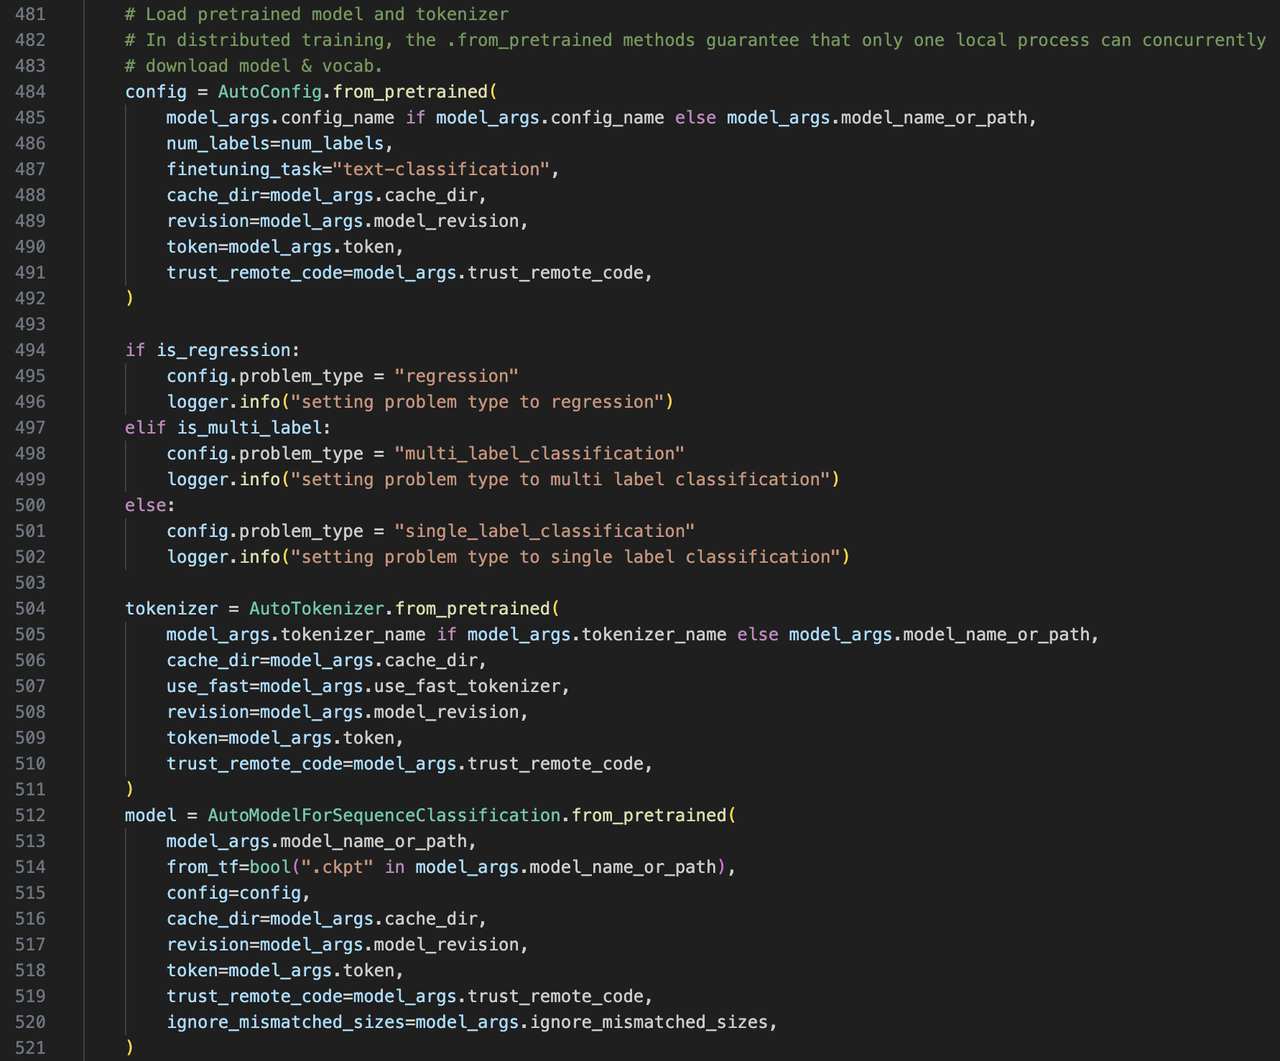\n",
"\n",
"4. 训练/验证/预测\n",
"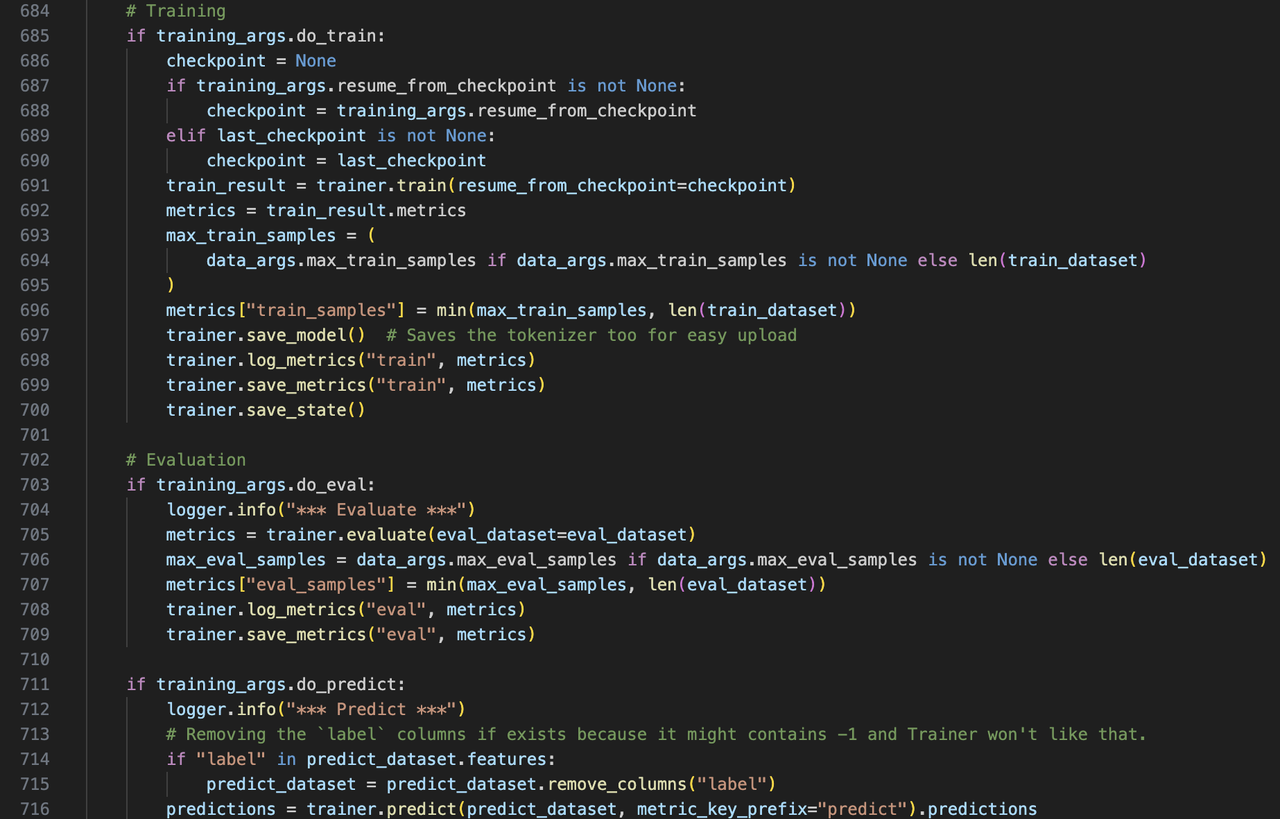\n",
"\n",
"#### 3.2 训练模型\n",
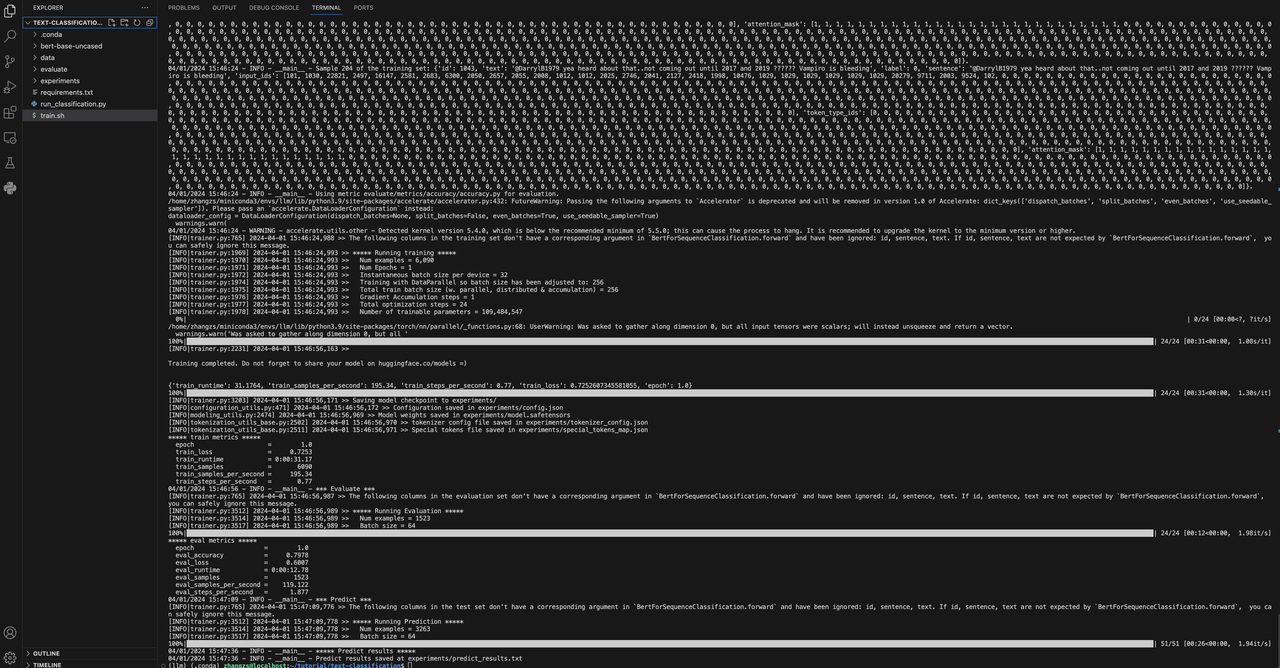
"同时在开发集上验证,在测试集上预测,执行下述脚本:\n",
"\n",
"```shell\n",
"python run_classification.py \\\n",
" --model_name_or_path bert-base-uncased \\\n",
" --train_file data/train.csv \\\n",
" --validation_file data/val.csv \\\n",
" --test_file data/test.csv \\\n",
" --shuffle_train_dataset \\\n",
" --metric_name accuracy \\\n",
" --text_column_name \"text\" \\\n",
" --text_column_delimiter \"\\n\" \\\n",
" --label_column_name \"target\" \\\n",
" --do_train \\\n",
" --do_eval \\\n",
" --do_predict \\\n",
" --max_seq_length 512 \\\n",
" --per_device_train_batch_size 32 \\\n",
" --learning_rate 2e-5 \\\n",
" --num_train_epochs 1 \\\n",
" --output_dir experiments/\n",
"```\n",
"\n",
"若出现报错或卡住,通常是网络问题:\n",
"\n",
"1. 下载模型时显示“Network is unreachable”,手动下载模型到本地:https://huggingface.co/google-bert/bert-base-uncased\n",
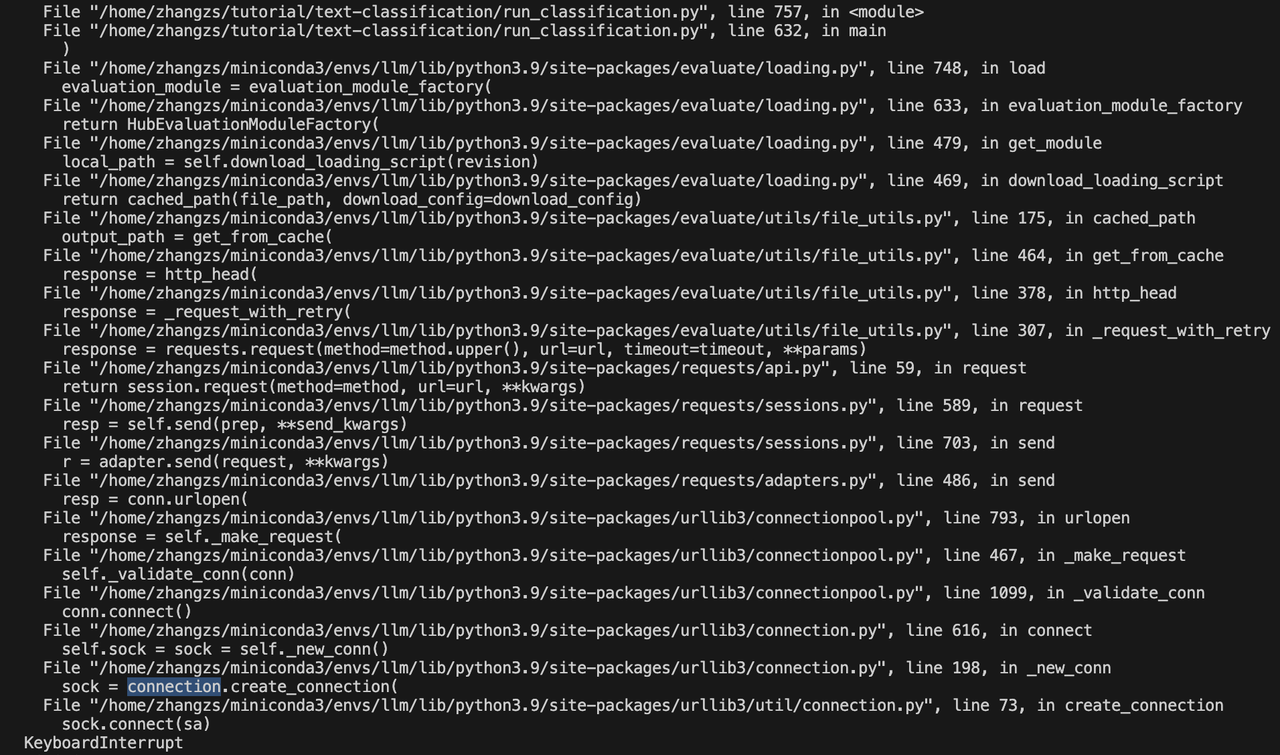
"2. 若加完数据后卡住不动,CTRL+C终止后显示卡在“connection”,则是evaluate包加载评价指标时网络连接失败所致。\n",
"\n",
"\n",
"\n",
"此时,可去evaluate的GitHub下载整个包:https://github.com/huggingface/evaluate/tree/main,并在超参数中将--metric_name路径改成本地的指标路径,即:\n",
"\n",
"```shell\n",
"python run_classification.py \\\n",
" --model_name_or_path bert-base-uncased \\\n",
" --train_file data/train.csv \\\n",
" --validation_file data/val.csv \\\n",
" --test_file data/test.csv \\\n",
" --shuffle_train_dataset \\\n",
" --metric_name evaluate/metrics/accuracy/accuracy.py \\\n",
" --text_column_name \"text\" \\\n",
" --text_column_delimiter \"\\n\" \\\n",
" --label_column_name \"target\" \\\n",
" --do_train \\\n",
" --do_eval \\\n",
" --do_predict \\\n",
" --max_seq_length 512 \\\n",
" --per_device_train_batch_size 32 \\\n",
" --learning_rate 2e-5 \\\n",
" --num_train_epochs 1 \\\n",
" --output_dir experiments/\n",
"```\n",
"\n",
"\n",
"\n"
]
},
{
"cell_type": "markdown",
"id": "9410f5c8",
"metadata": {},
"source": [
"### 4. 部署模型:模型训练完毕后,我们可以在Gradio Spaces上搭建在线demos\n",
"#### 4.1 Gradio Spaces教程\n",
"https://huggingface.co/docs/hub/en/spaces-sdks-gradio\n",
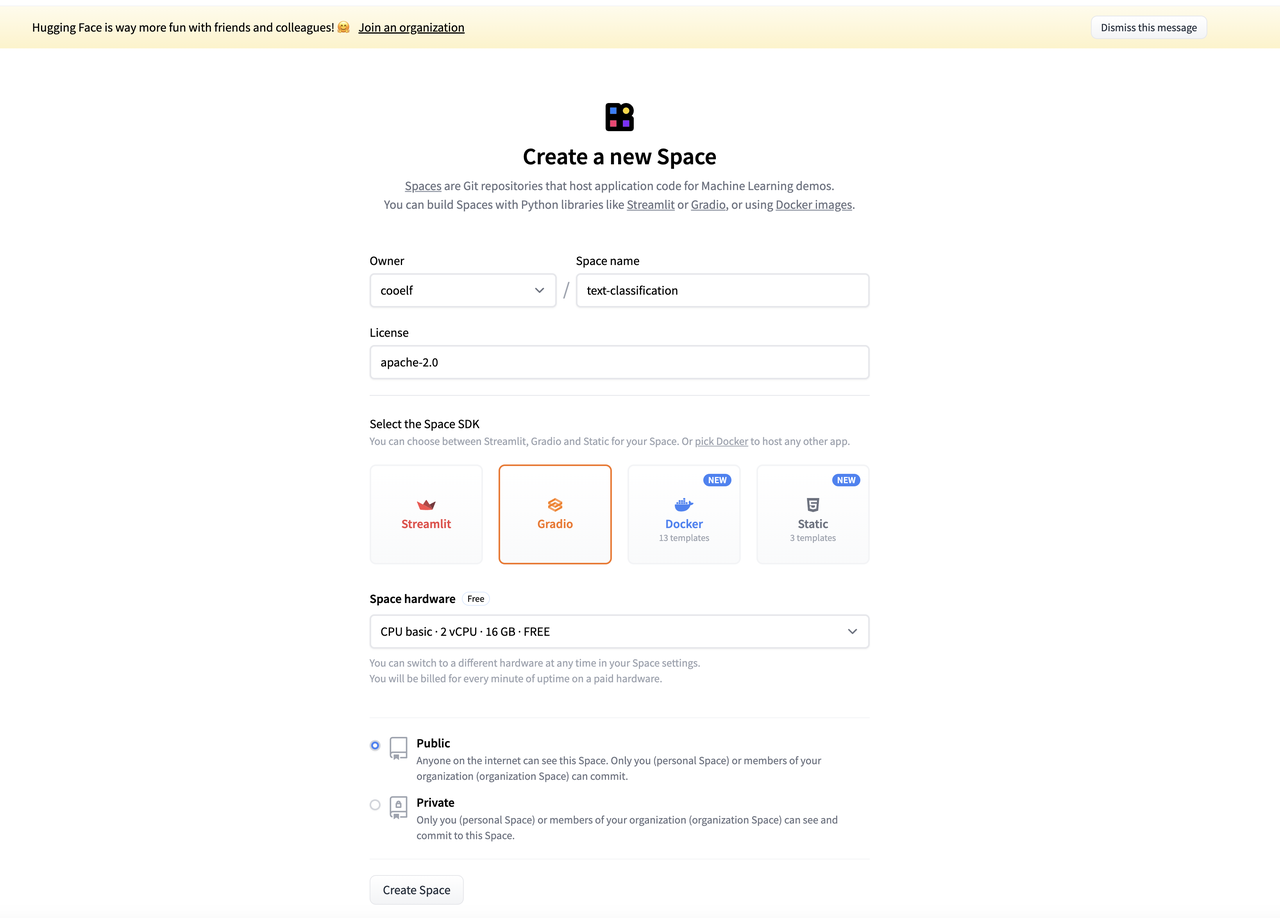
"#### 4.2 创建spaces\n",
"1. https://huggingface.co/new-space?sdk=gradio\n",
"2. Note:打不开的话请尝试科学上网\n",
"\n",
"\n",
"\n",
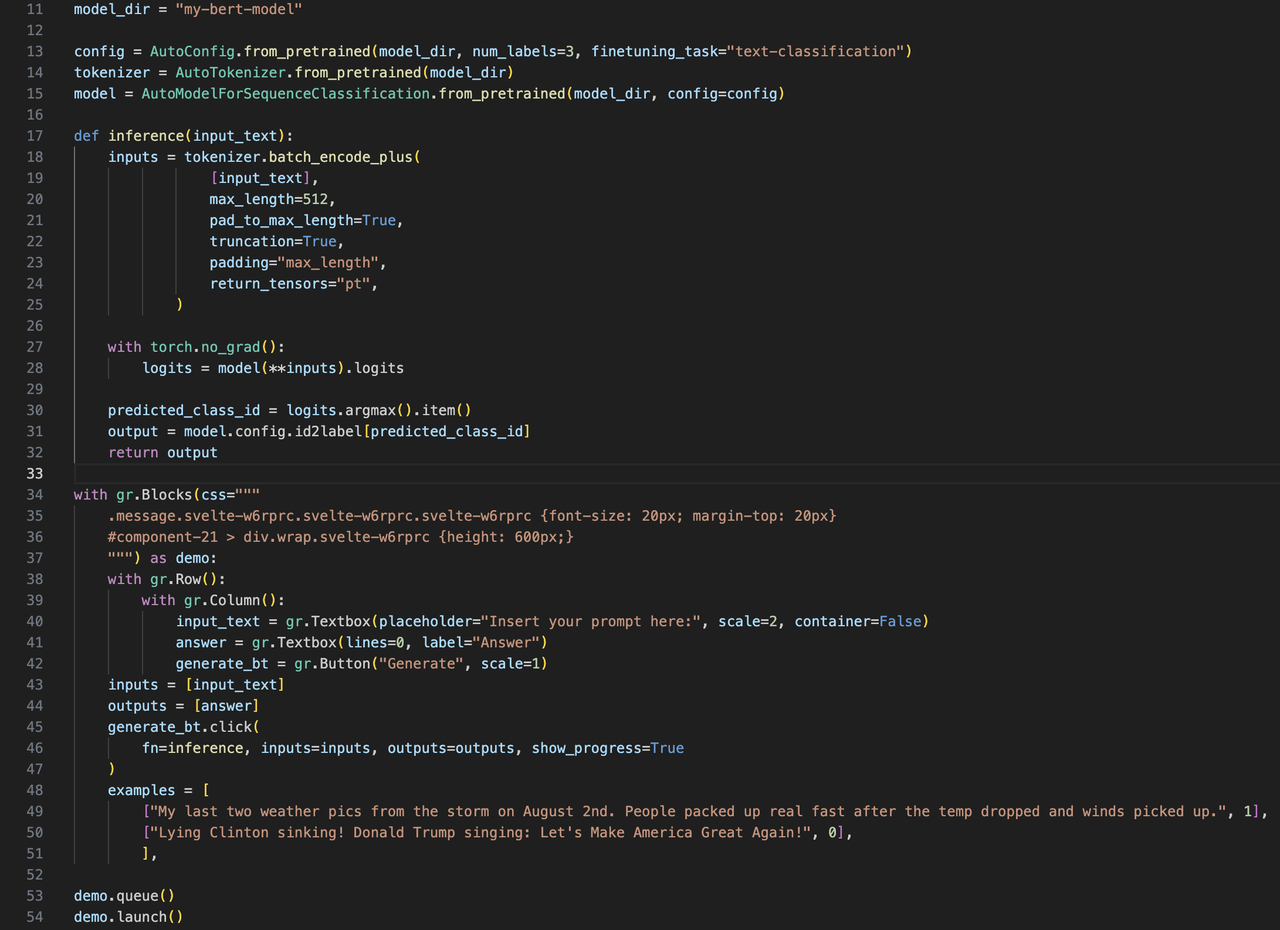
"#### 4.3 关键推理代码\n",
"具体见工程包中的app.py\n",
"\n",
"\n",
"\n",
"#### 4.4 将app.py、环境配置文件和模型上传到Gradio Spaces\n",
"1. 配置文件(requirements.txt)\n",
"```\n",
"transformers==4.30.2\n",
"torch==2.0.0\n",
"```\n",
"\n",
"2. 文件概览\n",
"\n",
"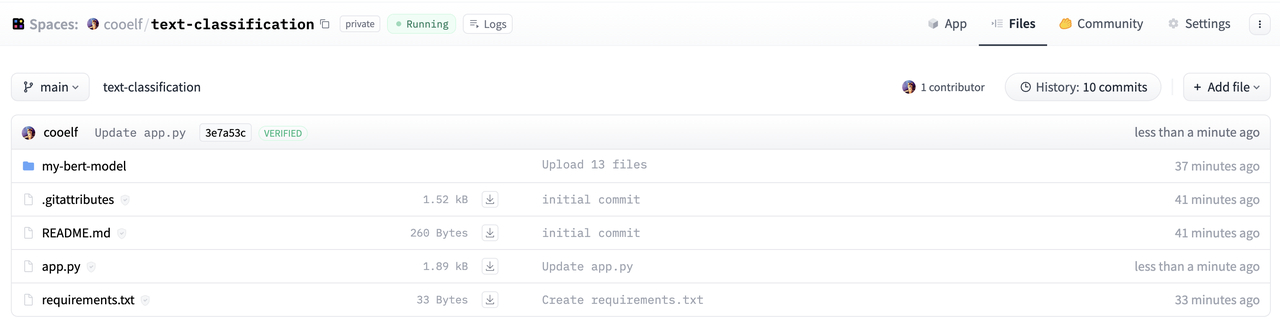\n",
"\n",
"\n",
"3. Demo效果\n",
"成功部署的案例供参考:https://huggingface.co/spaces/cooelf/text-classification\n",
"其中在右上角“Files”栏目可以看到源码。\n",
"\n",
"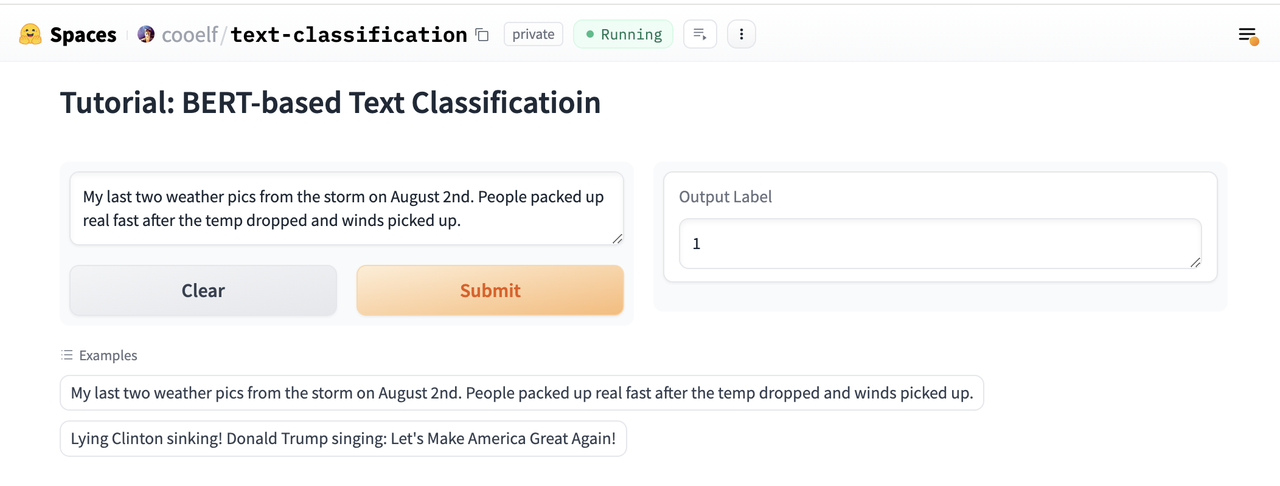\n",
"\n",
"\n",
"4. 彩蛋:在Spaces平台可以看到每周的热点Demo,且可以搜索感兴趣的大模型、Demo进行尝试\n",
"\n",
"\n"
]
},
{
"cell_type": "markdown",
"id": "6201b9ef",
"metadata": {},
"source": [
"### 5. 进阶练习\n",
"1. 试试其他分类/回归任务,例如情感分类、新闻分类、漏洞分类等\n",
"2. 试试其他类型的模型,例如T5、ELECTRA等\n"
]
},
{
"cell_type": "markdown",
"id": "86188b62",
"metadata": {},
"source": [
"### 6. 其他常用的模型\n",
"1. 问答模型:https://github.com/huggingface/transformers/tree/main/examples/pytorch/question-answering\n",
"2. 文本摘要:https://github.com/huggingface/transformers/tree/main/examples/pytorch/summarization\n",
"3. 调用Llama2进行推理:https://huggingface.co/docs/transformers/en/model_doc/llama2\n",
"4. 对Llama2进行轻量化微调(LoRA): https://github.com/peremartra/Large-Language-Model-Notebooks-Course/blob/main/5-Fine%20Tuning/LoRA_Tuning_PEFT.ipynb\n"
]
},
{
"cell_type": "markdown",
"id": "33ac6511",
"metadata": {},
"source": [
"### 7. 延伸阅读\n",
"1. 一篇对大语言模型(LLMs)进行全面、深入分析的43页[综述](https://mp.weixin.qq.com/s?__biz=Mzk0MTYzMzMxMA==&mid=2247484539&idx=1&sn=6ee42baab4ad792e74ac6a89d7dd87d9&chksm=c2ce3e0af5b9b71c578cb6836e09cce5f60b4a1cfffadc1c4c98211fc0af621bfaaaa8fe0aff&mpshare=1&scene=24&srcid=0331FO6iqVqs5Vx3iHrtqouQ&sharer_shareinfo=45c3fb78d9cfb9627908da44dd7f5559&sharer_shareinfo_first=45c3fb78d9cfb9627908da44dd7f5559&key=a2847c972f830c4143e00e0430f657d8ab5acae4ad24ca628213273021453a3a9e17984627e2ab8506d1dcf6e1fabd9ec3123a5f71d2a65295ad6f6f56da2224d4a6e3228237c237447bbf48a6eff1f53e1971503f26c3fb5b9d99d27eca7266529a5f86d75bada7ec10bf314687bfcbf9fa3b09b8e36e73f6d6a154a5ce5ff0&ascene=14&uin=NzE3NzkyOTQx&devicetype=iMac20%2C1+OSX+OSX+14.2.1+build(23C71)&version=13080610&nettype=WIFI&lang=zh_CN&countrycode=CN&fontScale=100&exportkey=n_ChQIAhIQM7tgcovlhXp1y5J%2BRMnhfhL3AQIE97dBBAEAAAAAAFsTBwTm4FMAAAAOpnltbLcz9gKNyK89dVj0MxFZswDc%2Fk646vJPW2S3JFh8H2JhyZXiPbIl%2Bh23CsewrmIoZ4j0D2zMNylC3pLbhu9FIARUKYn%2F0r0OIdHnxesVFpw1qLo6uBJ3zmbsKBVXM05%2B0MiOBIfShfpiIfraK7THzak94U0RdS1flC%2BIDjTb5SmZs9Z4XTyTsN0QXR6NWjAXFeuxnMB4SENMJ8dUR8n08b3DGKtz9rfefn0JRlsX4mGcLvOFsFwg4nk35nl4C3Wgcs4OYociKm5UHabdhWT7%2FWbNNToZLD39eD%2FL4Xo%3D&acctmode=0&pass_ticket=8xG4QKOnJeEFUtXkScVmMqb3omdWJbPuc%2BhN5%2BA7%2FOXj7ex757M2ABNO4GVVnv2T3VtqrC9gZH%2FrU09rrUxJcA%3D%3D&wx_header=0)(Word2Vec作者出品)\n",
" \n",
" 论文题目:Large Language Models: A Survey\n",
"\n",
" 论文链接:https://arxiv.org/pdf/2402.06196.pdf\n",
"\n",
"2. [GPT,GPT-2,GPT-3 论文精读【论文精读】](https://www.bilibili.com/video/BV1AF411b7xQ?t=0.0)\n",
"\n",
"3. [InstructGPT 论文精读【论文精读·48】](https://www.bilibili.com/video/BV1hd4y187CR?t=0.4)\n"
]
}
],
"metadata": {
"language_info": {
"name": "python"
}
},
"nbformat": 4,
"nbformat_minor": 5
}